
图片里的字选不中、扫描件复制不了:Umi-OCR 开源免费全程离线,一次能认几百张
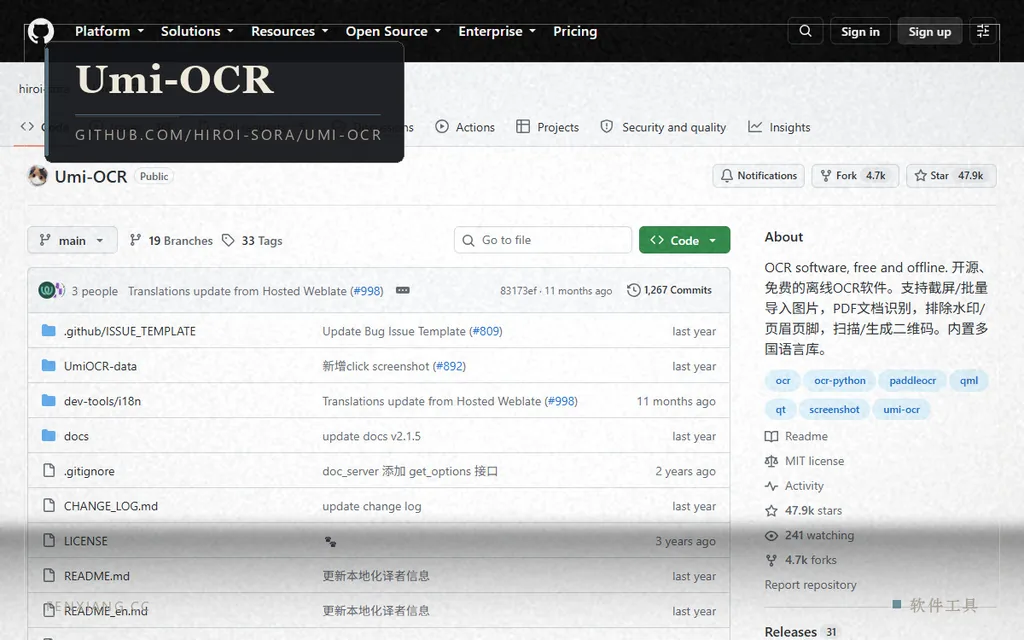
有三件事几乎所有人都遇到过:网页上的一张图片里印着一段文字,可你就是选不中、复制不了;扫描版 PDF 打开是一张张图,搜索和复制全都失效;聊天记录里对方发来一张截图,你想把里面的地址或单号提出来,只能一个字一个字敲。
市面上的解法大体两类:一类是微信、QQ 自带的截图识字,方便,但只能一张一张来、还得联网;另一类是各种在线 OCR 网站,把图片上传到它的服务器,免费档往往还带次数或体积限制。两类方案共同的问题是——你并不清楚那张图最后留在了哪里。
Umi-OCR 走的是第三条路:识别完全在你自己的电脑上完成,不联网、不上传,而且免费开源。
它是什么
Umi-OCR 是一款开源的离线 OCR 工具,用 MIT 许可发布,作者是国内开发者。它的定位很明确:把「图片里的字变成能复制、能编辑、能搜索的文本」这件事做成一个装在本地的小工具。目前发布包已经更新到 v2.1.5,GitHub 上四万多的 star 也说明它在中文用户里流传得有多广。
关键的几个前提先说清楚:
- 完全离线——所有识别都在本机进行,图片和文字不出你的硬盘。这一点对企业内网、涉密资料、带个人信息的截图特别重要。
- 免费开源、无水分——MIT 许可,没有隐藏收费、没有订阅、没有使用次数上限、识别结果也不加水印。
- 绿色免安装——发布包是
.7z.exe自解压包,解压出来双击就能跑,不需要装、不需要注册表、不需要登录。 - 跨平台——Windows 7 及以上,以及 Linux x64(Debian 系)。占用约 200MB 磁盘空间,对老机器也算友好。
- 语言覆盖面大——官方称支持 100 多种语言的文字识别,含中文、英文、日文、韩文、俄文、德文、法文及多数欧洲语言。
核心能力
| 能力 | 具体怎么用 |
|---|---|
| 截图识别 | 最常用的功能。按快捷键(默认 Win+Alt+C,可自行改)唤起截图,框选屏幕任意区域,文字立刻出现在右侧识别记录里,可直接编辑、划选复制 |
| 批量识别 | 一次导入几百张图片连续处理,不设数量上限,结果可批量导出 |
| PDF 扫描识别 | 把扫描版 PDF 里的文字抽出来,还能生成可搜索的双层 PDF(原文图 + 隐藏文本层),之后就能检索、复制 |
| 二维码 / 条码 | 识别图片里的二维码,并支持 19 种条码;反过来也能生成二维码 |
| 公式识别 | 把图片里的数学公式转成 LaTeX 代码,写论文、做笔记时省一大截事 |
| 版面处理 | 支持排除水印、页眉页脚等干扰内容,避免识别结果里混进一堆重复文字 |
| 手写体 | 印刷体和手写体都能认,但手写部分的准确率取决于字迹是否清楚、工整 |
两个版本怎么选
Umi-OCR 的 Windows 包按识别引擎分成两个版本,功能完全一样,区别只在引擎和硬件要求上:
| 版本 | 体积 | 特点 |
|---|---|---|
| Paddle 引擎版 | 约 128MB | 精度更高,适合版面复杂的文档;但不兼容奔腾、赛扬、凌动这类老旧 CPU,配置一般的机器别选它 |
| Rapid 引擎版 | 约 98.5MB | 体积更小、内存占用更低、兼容性最好,日常识别的准确率完全够用——拿不准就下这个 |
上手只要三步
- 从官方仓库的 Release 里按机器情况下 Paddle 版或 Rapid 版,解压到非系统盘(比如 D 盘),别放在 C 盘根目录或系统目录里。
- 进文件夹双击
Umi-OCR.exe,程序直接打开,整个过程不需要联网。第一次启动会按系统语言自动显示中文界面。 - 切到「截图 OCR」标签页,按
Win+Alt+C框选屏幕上的文字区域,识别结果就出现在右侧栏,可以直接编辑、划选复制。
和别的方案比
| 方案 | 代价 |
|---|---|
| 微信 / QQ 截图识字 | 免费且顺手,但要联网、一次只能来一张,拿不到批量能力 |
| 在线 OCR 网站 | 图片必须先上传到对方的服务器,多数有免费次数或文件体积限制,敏感资料要掂量 |
| 收费 OCR 软件 | 功能往往单一,或者识别次数按套餐算,性价比一般 |
| Umi-OCR | 要自己下一次、解压一次;换来的是完全离线、不收钱、不设限,截图 / 批量 / PDF / 条码一条龙 |
几个值得先知道的点
- 「离线」不等于「百分之百准」——印刷体、清晰文档的效果最好;倾斜、模糊、低分辨率的图会掉点准确率,重要内容建议人工过一遍。
- 公式识别有自己的适用范围——它解决的是「把公式图变成 LaTeX」,复杂排版或手写公式仍需要校对。
- Linux 只有 x64(Debian 系),用别的发行版或 ARM 设备别指望直接套用。
- 别从第三方下载站拿——这个项目只通过 GitHub 官方仓库(以及作者提供的镜像与网盘)分发,所谓「XX 官网」多为转载站,包是否被动过没人担保。
- 手写体识别看字迹——能认,但潦草的手写内容准确率会明显下降。
一句话总结:如果你的需求是「经常要把图片、截图、扫描件里的字抠出来」,又不想把文件传到别人的服务器上,Umi-OCR 基本是目前最省心的免费选择——装一次,之后离线用一辈子,不花钱、不设限。
↓ 获取资源
点击按钮直接前往资源页面。
相关资源
更多「软件工具」
把 ElevenLabs 那套搬回自己电脑:VoiceStudio 用 AGPL-3.0 开源了克隆、配音、听写、转写六合一,六个平台全本地跑,代价是 Windows 上 A 卡只能吃 CPU
一段 5 到 15 秒的干净人声,加上文字,就能合成同一个人说话;顺手还能给外语视频配音、把会议录音转成文字、把整本有声书批…
网页 34,873 字符的 HTML 去掉噪音只剩 15,371 字符:Firecrawl 一套 compose 自建抓取服务,把整站变成模型能读的 Markdown
让 AI 读一个网页,真正费劲的不是「抓下来」,而是「抓下来之后哪一段才是正文」。Firecrawl 开源版干的就是这一步:…
装别人的 skill 之前先扫一遍:NVIDIA 把 71 种投毒模式做成扫描器,3 万个技能里 26% 有问题
现在给 AI 助手装一个 skill,本质是把陌生人的提示词、脚本和依赖装进你的终端。NVIDIA 开源的 SkillSpe…